首页 > 专题专栏 > 优化营商环境助力高质量发展 > 营商信息
园区企业智子引擎在多模态数学推理探索中取得新突破
日期:2025-03-20 15:44 来源: 中关村门头沟园
字号: 大 中 小
DeepSeek-R1通过强化学习算法,增强了大语言模型的复杂推理能力,使模型在回答问题之间会生成完整的思考过程,从而大大提高了模型回答的准确性。那么,我们是否可以使用类似的强化学习算法,增强多模态大模型的复杂推理呢?
近日,针对这一挑战,来自京西智谷企业智子引擎的研究团队开源了具有复杂推理能力的多模态大模型Awaker2.5-R1,主要贡献者为算法工程师龙金强。
相较于大语言模型,多模态大模型的复杂推理场景更为复杂,其必须严格依赖视觉信息进行推理才有意义。因此,Awaker2.5首先针对多模态数学推理进行探索,因为数学推理严格依赖数学图表提供的信息。
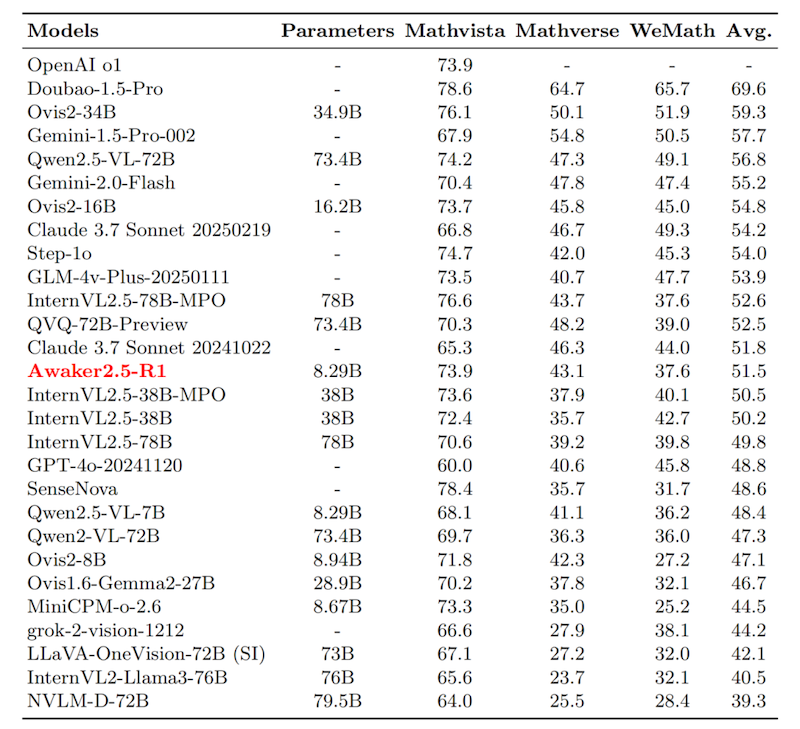
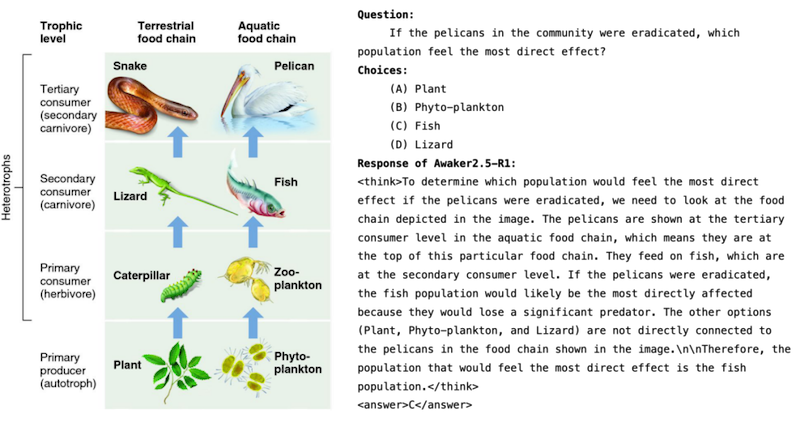
Awaker2.5-R1以Qwen2.5-VL-7B作为基座模型,使用GRPO算法进行训练,使用了近5万条训练数据训练2个epoch。研究团队在三个常用的数学Benchmark上进行测评,分别是MathVista(Testmini),MathVerse(Testmini&visionOnly)和WeMath,评测结果如上表所示。表中其他模型的测评结果均来源于OpenCompass最新榜单。我们发现,相较于baseline模型Qwen2.5-VL-7B,Awaker2.5-R1在三个Benchmark上均有一定增长,其中在Mathvista上性能增长最为明显,以7B模型尺寸达到73.9,逼近OpenAI的o1模型(o1在MathVista上得分也是73.9)。在同等规模的模型中,Awaker2.5-R1表现最好,甚至超越一些更大规模(38B、78B等)的开源模型。下图展示了Awaker2.5-R1进行复杂推理的例子(来自MathVista),可以观察到模型在生成最终答案时,会生成较长的思维链进行推理。目前,Awaker2.5-R1已经开源,可进行本地部署体验。智子引擎研究团队后续将对Awaker2.5-R1进行持续升级,特别是在通用推理和模型架构上进行重点实践;还将探索Awaker2.5-R1在国家电网、城市治理等复杂场景中的落地应用。
 微博
 微信